Von Black Box zu Glass Box: Wie sich KI-Agenten im Produktivbetrieb kontrollieren lassen

KI-Agenten verstehen und schlussfolgern inzwischen so gut, dass die Versuchung groß ist, ihnen ohne Weiteres die volle Kontrolle über Automatisierungssysteme zu überlassen. Agent-SDKs sind so ausgereift, dass sich mit einer langen Liste von Tools und umfangreichen Prompts innerhalb eines Tages eine Pipeline aufsetzen lässt. Diese Geschwindigkeit hat jedoch ihren Preis: Wer den Agenten die Schlüssel übergibt, übernimmt auch ihre Varianz.
Stellen Sie sich ein modernes Verkehrsflugzeug vor. Der Pilot fliegt, doch ein Flugcomputer hält das Flugzeug innerhalb eines sicheren Flugbereichs (Envelope). Agentische Systeme brauchen dieselbe Aufteilung: Das LLM ist der Pilot, der Code bildet den Envelope. Fehlt diese Trennung, treten zwei Probleme auf:
- Über wiederholte Durchläufe hinweg sinkt die Zuverlässigkeit. Auf τ²-bench [1], einem Benchmark, der mehrstufige Kundenservice-Aufgaben mit Tool-Nutzung simuliert, löst Claude Opus 4.5 dieselbe Retail-Aufgabe nur in etwa der Hälfte der Fälle bei allen vier Wiederholungen erfolgreich (pass^4: 51,8 %, Leaderboard abgerufen im Oktober 2026) [2].
- Multi-Agenten-Systeme scheitern auf vorhersehbare Weise. Eine Studie ordnete die Fehler 14 Kategorien und 3 Hauptgruppen zu: (i) Probleme im Systemdesign, (ii) mangelnde Abstimmung zwischen den Agenten und (iii) fehlende Verifikation der Aufgabe [3]. Die meisten davon sind Engineering-Probleme, keine Modellprobleme.
Um diese Fehler zu beheben, muss der Code den Workflow, die Eingaben, die Verifikation und den Umgang mit Unsicherheit verantworten, während das LLM für das Reasoning zuständig ist.
Diese Disziplin wird mitunter als Harness Engineering bezeichnet. Um beim Bild des Flugzeugs zu bleiben: Das Modell fliegt, der Harness ist alles drumherum: der Kontrollfluss, die Tools, die Prüfungen und feste Obergrenzen für Runden, Tool-Aufrufe und Kosten. Als Machine Learning Engineer bei Merantix Momentum bringe ich agentische Systeme aus der Sandbox in den realen Produktivbetrieb. Im Folgenden stelle ich acht Harness-Patterns vor, mit denen wir Kontrolle, Zuverlässigkeit und Sicherheit in solche Systeme einbauen.
Wie diese Patterns in der Praxis funktionieren, zeigen wir an einem anschaulichen Beispiel: einem Compliance-Agenten, der Hardwarekomponenten auf die Einhaltung regionaler Sicherheits- und Umweltstandards prüft. Einem LLM einfach die Produktspezifikationen und eine Gesetzesdatenbank zu übergeben, wäre riskant. Dieselbe Komponente könnte in einem Durchlauf als konform, und im nächsten als nicht konform eingestuft werden, jedes Mal mit einer überzeugend klingenden Begründung. Die folgenden Abschnitte zeigen Pattern für Pattern, wie sich das verhindern lässt.
Workflow statt Autonomie: deterministische Orchestrierung
Die erste Frage lautet: Kennen Sie den Ablauf des Workflows schon im Voraus? Bei offenen Aufgaben wie Recherche oder Debugging ist das meist nicht der Fall. Dort ist ein LLM-Orchestrator im Vorteil, der seine nächsten Schritte selbst plant und ausführt. Der Preis dafür ist weniger Vorhersagbarkeit, und Fehler sind schwerer zu erkennen. Lässt sich das Flussdiagramm dagegen schon vor dem Start zeichnen, bringt es nur unnötige Varianz, wenn das Modell den Ablauf bei jedem Durchlauf neu herleitet. In diesem Fall gilt: Die Übergänge zwischen den Stufen legt der Code fest, und innerhalb jeder Stufe hat der Agent begrenzten Spielraum. Zwei Designs eignen sich dafür:
- Ein Directed-Acyclic-Graph Workflow (DAG) legt den Kontrollfluss über statische Knoten und Kanten deterministisch fest. Er eignet sich hervorragend für vorhersehbare oder lineare Pipelines, etwa eine klassische Retrieval-Augmented-Generation-Pipeline (RAG).
- Eine Finite-State Machine (FSM) erlaubt Zyklen zwischen Zuständen, sobald bestimmte Bedingungen erfüllt sind. Das ermöglicht Iterationen, Fehlerkorrektur und Retry-Schleifen für teilautonome Agenten.
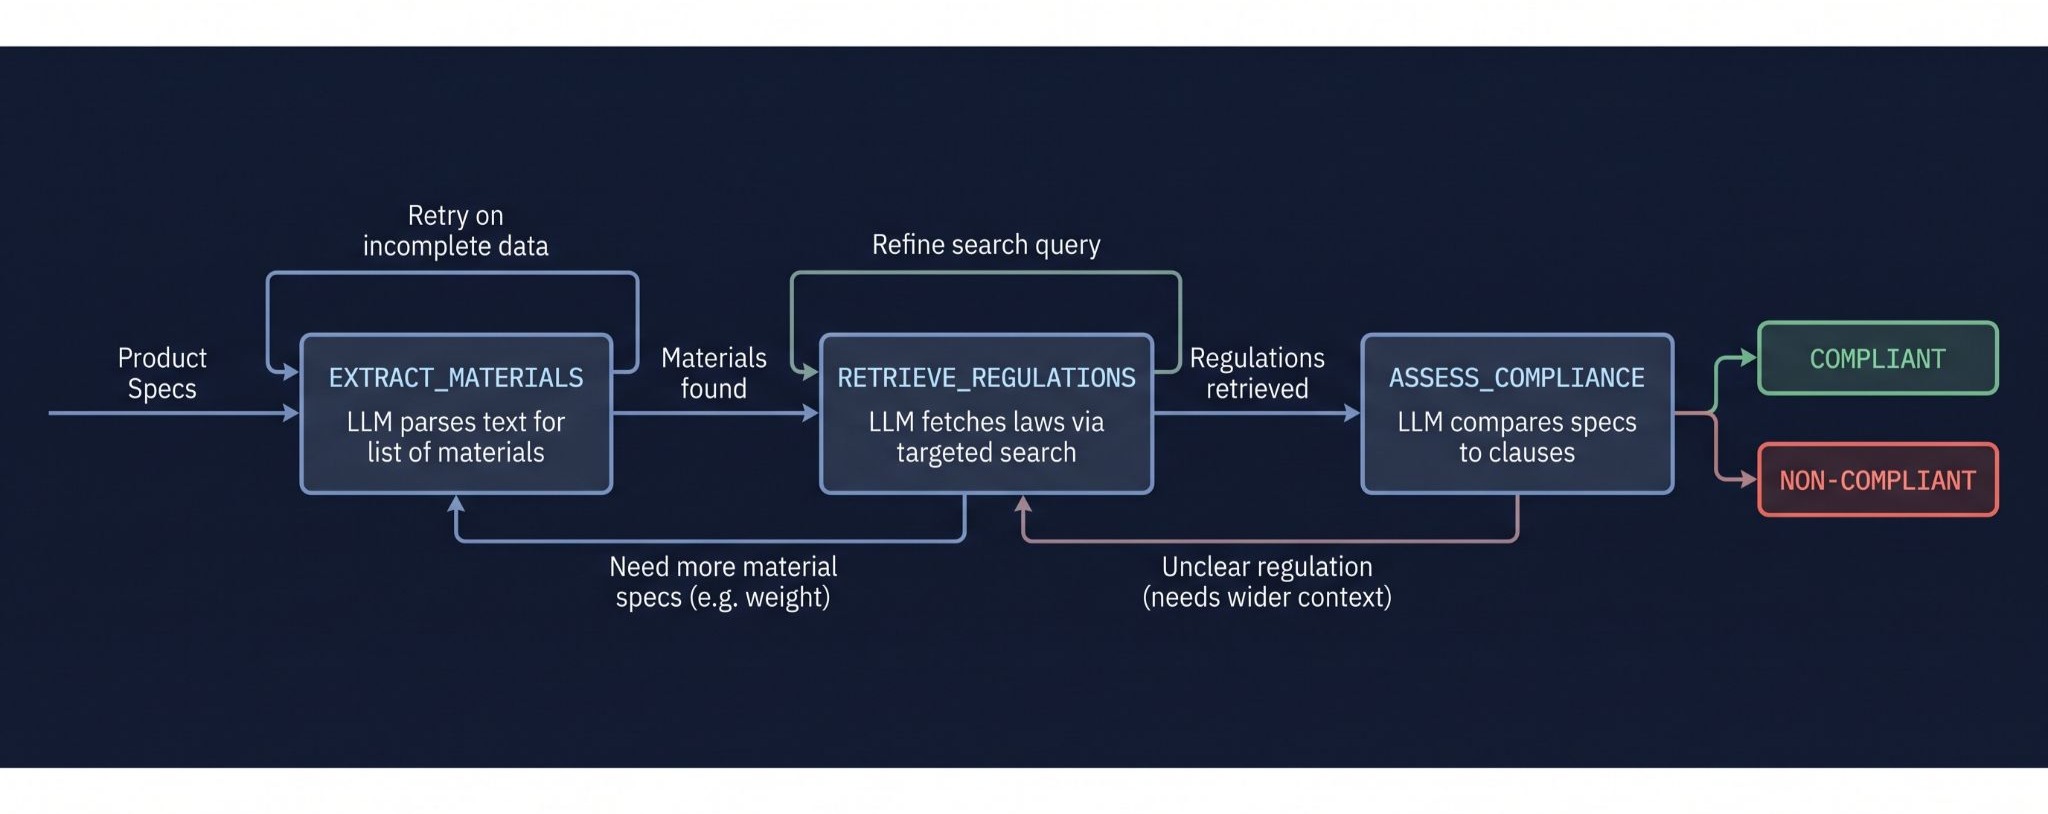
Im Compliance-Agenten verhindert eine FSM, dass das LLM von seiner Aufgabe abweicht. Wir definieren feste Zustände: Extract_Materials -> Retrieve_Regulations -> Assess_Compliance. Innerhalb eines Zustands schlussfolgert das LLM und darf iterieren. Über die Übergänge entscheidet jedoch der deterministische Code, anhand validierter Felder in den Ausgaben des Modells.
Fachliteratur und Benchmark-Aufgaben zeigen, dass der Wechsel von einer rein stochastischen ReAct-Schleife (Reason + Act) [4] zu einer FSM-Architektur die Erfolgsquote bei realen Workflows deutlich steigert und gleichzeitig die Kosten senkt. Das StateFlow-Framework [5] erzielte bei Decision-Making-Aufgaben eine um 28 % höhere Erfolgsquote und bei der Code-/Datenausführung eine um 13 % höhere Erfolgsrate, bei 3- bzw. 5-mal niedrigeren Kosten. Ein weiterer Vorteil fester Stufen: sie lassen sich einzeln testen und debuggen, wodurch das System deutlich leichter wartbar wird.
Den Handlungsspielraum begrenzen: Der Agent entscheidet, was passiert; der Code entscheidet, wo
Statische Stufen und Übergänge geben uns die Kontrolle über die Umgebung. Sie garantieren jedoch nicht, dass der Agent die Bedingungen für seine Aktionen korrekt erfüllt. Aktionen lösen Übergänge auf Basis der strukturierten Ausgabe des LLM aus, und diese kann falsch formatiert sein oder über den erwarteten Handlungsspielraum hinausgehen. Füllt ein LLM die Tool-Parameter selbst aus, kann es einen ungültigen Wert vorschlagen oder, schlimmer noch, einen gültigen, aber falschen Wert (z. B. Region UK statt EU). Dann scheitert das System, ohne dass es jemand bemerkt.
Der Code muss kontrollieren, was das LLM verwenden darf. Beim Compliance-Agenten bestimmt das Modell Region und Schweregrad nicht selbst, wenn es eine Komponente beanstandet. Stattdessen setzen wir gezielte Schutzmechanismen ein:
- Parameter Binding: Parameter (Region: EU) werden direkt aus der Anfrage übergeben. Das Modell sollte niemals einen Wert erzeugen, den das System bereits kennt.
- Tool-Scoping nach dem Least-Privilege-Prinzip: Jeder Agent erhält nur die kleinstmögliche Auswahl an Tools, die er in seinem aktuellen Zustand benötigt.
- Auswahl aus festen Werten: Das Ergebnis wird als Enum deklariert ((COMPLIANT, NON_COMPLIANT, NEEDS_REVIEW) und über Structured Outputs erzwungen. So kann das Modell keinen Wert außerhalb dieser Menge erzeugen.
Mit diesen Design-Patterns gibt es weniger unbemerkte Fehler und eine kleinere Angriffsfläche. Außerdem lassen sich verbleibende Fehler direkt dem Reasoning des Modells zuordnen statt der technischen Anbindung.
Context Engineering: Geben Sie Ihrem Agenten die relevanten Informationen
Kontextfenster sind enorm gewachsen. Selbst günstige Modelle wie Claude Haiku 5.5 verarbeiten inzwischen 1 Million Input-Tokens. Daraus entsteht eine gefährliche Versuchung: einfach alle verfügbaren Informationen in den Kontext zu laden und das Modell die Nadel im Heuhaufen suchen zu lassen. Das beworbene Kontextfenster ist jedoch nicht das nutzbare. Auf NoLiMa [6] erreichen die meisten der 12 getesteten Long-Context-Modelle schon bei 32.000 Tokens weniger als die Hälfte ihres Ergebnisses mit kurzem Kontext. Selbst GPT-4o fällt von 99,3 % auf 69,7 %. RULER [7] stellt dieselbe Lücke zwischen angegebener und tatsächlich nutzbarer Kontextlänge fest.
Beim Compliance-Agenten heißt die Prüfung auf beschränkte Stoffe nicht, ihm das gesamte EU-Recht mitzugeben. Stattdessen koppeln wir ihn an ein Retrieval-Tool, das speziell für juristische Texte entwickelt wurde. Dasselbe Prinzip lässt sich auf andere Tool-Aufrufe übertragen, etwa auf die Websuche. Statt den vollständigen Seiteninhalt mit 50.000 Tokens zurückzugeben, liefert das Tool nur Textausschnitte rund um bestimmte Produktmerkmale (z. B. „Bleigehalt im Lot“), die der Agent als Suchbegriffe gewählt hat. Das Ergebnis: weniger Tokens pro Aufruf, weniger Störinformationen, die das Modell fehlinterpretieren könnte, und reproduzierbare Extraktionen.
Begrenzte Autonomie: Budget und Sicherheitsnetz
Bei Interaktionen über viele Runden hinweg kann die Leistung eines Agenten nachlassen. Neben Halluzinationen und dem Verlorengehen in langen Kontexten neigt ein LLM zum Overthinking: Es gibt internen Überlegungen den Vorrang vor konkreten Aktionen. Trajektorien mit wenig Overthinking erzielen dagegen schätzungsweise rund 30 % bessere Ergebnisse bei 43 % weniger Rechenaufwand [8].
Angenommen, der Lieferant hat für einen Kondensator, den der Compliance-Agent gerade prüft, nie ein Datenblatt veröffentlicht. Ohne Grenzen könnte der Compliance-Agent sein gesamtes Kontextfenster aufbrauchen, weil er immer wieder nach einer Information sucht, die es schlicht nicht gibt. Ein konkretes Ziel ist daher, die Zahl der Iterationen pro Agent durch klare Grenzen zu reduzieren:
- Rundenbudget mit Hinweis auf die letzte Runde: Die Zahl der Runden, die der Agent nutzen darf, wird begrenzt. Ein Hinweis vor der letzten Runde stellt sicher, dass der Agent ein vollständiges Ergebnis liefert, bevor der harte Abbruch greift.
- Budgetbewusste Tool-Nutzung: Für jedes Tool gilt ein Aufruflimit, und das verbleibende Budget wird in jeder Runde angezeigt. Das bringt den Agenten dazu, seine Strategie zu optimieren [9].
- Finalizer-Agent: Er dient als Sicherheitsnetz. Gehen dem Compliance-Agenten bei der Suche nach dem fehlenden Datenblatt die Runden aus, übernimmt der Finalizer, fasst die vorhandenen Belege zusammen und beendet den Workflow kontrolliert.
Diese Leitplanken begrenzen nicht nur Overthinking und senken die Kosten, sie geben auch Kontrolle über Latenz und Ausgaben pro Durchlauf, und jeder Durchlauf endet mit einem verwertbaren Ergebnis.
Reasoning strukturieren: Belege vor Antworten
Häufig wird angenommen, das Reasoning eines LLM sei eine Black Box: Den Prompt kann man anpassen, das Denken selbst nicht. Dabei wird ein Hebel oft übersehen, mit dem sich das Reasoning direkt beeinflussen lässt: Output-Schemas.
Format und Vollständigkeit der Ausgabe sind für agentisches Reasoning entscheidend. Beim Compliance-Agenten ist kein Ergebnis möglich, solange die Belege nicht aufgeführt sind. Vor der Schlussfolgerung verlangt das Output-Schema die genaue Rechtsvorschrift (z. B. Artikel 4 Absatz 1) und die passende Materialspezifikation. Das Modell muss also erst die Belege in seinem Kontext finden, bevor es zu einem Urteil kommen kann.
Eine strukturierte Liste gefundener Fakten im Output-Schema zwingt das LLM, in seinem Kontext nach Belegen zu suchen. Als Zusatznutzen entsteht so sofort ein Audit-Trail für menschliche Prüfer. Auf dem ELI5-Benchmark von ALCE fehlt selbst den besten Modellen in 50 % der Fälle eine vollständige Stützung durch Quellenangaben [10]. Zitiert ein Agent eine Quelle oder ein Tool, das er während des Durchlaufs nie abgefragt hat, kann das System dies sofort als erfundenen Beleg kennzeichnen.
Verifikation außerhalb des Modells: Vertrauen ist gut, Kontrolle im Code ist besser
LLMs bewerten ihre eigenen Ausgaben tendenziell besser [11], und Selbstkritik kann die Leistung sogar verschlechtern. Auch ein zweites Modell verhindert nicht, dass derselbe Denkfehler oder dieselbe Datenlücke erneut auftritt. Setzen Sie deshalb immer auf eine belastbare externe Verifikation, etwa einen Abgleich mit Referenzdaten als Ground Truth, deterministische Korrekturen oder Schema-Validatoren.
Beim Compliance-Agenten erhält jeder Verstoß eine Risiko-ID, die in der offiziellen Risikotaxonomie nachgeschlagen wird. Halluziniert das LLM einen nicht existierenden Code, fängt ihn der deterministische Code-Validator ab. Daraufhin wird genau ein korrigierender Neuversuch ausgelöst, bei dem die nächstliegenden gültigen Optionen aufgelistet werden. Ist auch der korrigierte Code ungültig, wird der halluzinierte Code mit einem Fallback-Wert gekennzeichnet, bevor er unbemerkt in nachgelagerte Systeme gelangt. Kann die Prüfung selbst nicht ausgeführt werden (Ladefehler, Timeout), gilt das Ergebnis als „nicht verifiziert“: ein dritter Zustand, der sich sowohl von „bestanden“ als auch von „nicht bestanden“ unterscheidet.
Varianz als Signal nutzen: Konsens und kalibrierte Unsicherheit
Varianz zwischen verschiedenen Durchläufen gilt oft als Rauschen oder als Zeichen dafür, dass ein Ergebnis unsicher ist. Richtig genutzt zeigt sie jedoch, wie verlässlich ein Ergebnis ist und welche Fälle ein Mensch prüfen sollte.
Die erste Möglichkeit, diese Varianz zu nutzen, ist ein Mehrheitsentscheid im Sinne der „Weisheit der Vielen“. Erzeugt man in parallelen Durchläufen mehrere Antworten und führt die Ergebnisse zusammen, steigt die Zuverlässigkeit und es gibt weniger Halluzinationen. Allerdings vervielfachen sich dadurch die Kosten, und bei einem systematischen Fehler ist eine hohe Genauigkeit trotzdem nicht garantiert.
Günstiger sind Redundanz und Abgleich. Beim Compliance-Agenten prüfen zwei Bewertungsagenten parallel dieselbe Komponente. Jeder Agent formuliert seine eigenen Tool-Abfragen und schlägt damit einen anderen Weg ein. Der eine sucht nach „Grenzwerte für Bleigehalt“, der andere nach „Ausnahmen für Lote“, und womöglich kommen sie zu unterschiedlichen Schlüssen. Sind sie sich uneinig, übernimmt ein Reconciler-Agent. Er wertet die Belege beider Agenten gemeinsam aus und nimmt eine neue Klassifizierung vor. Damit unterscheidet sich der Reconciler grundlegend von einem Modell, das eine bereits vorliegende Antwort nur noch einmal bewertet: Er stützt sich auf die Belege aus zwei unabhängigen Suchwegen und hat damit mehr Informationen als jeder der beiden Agenten allein.
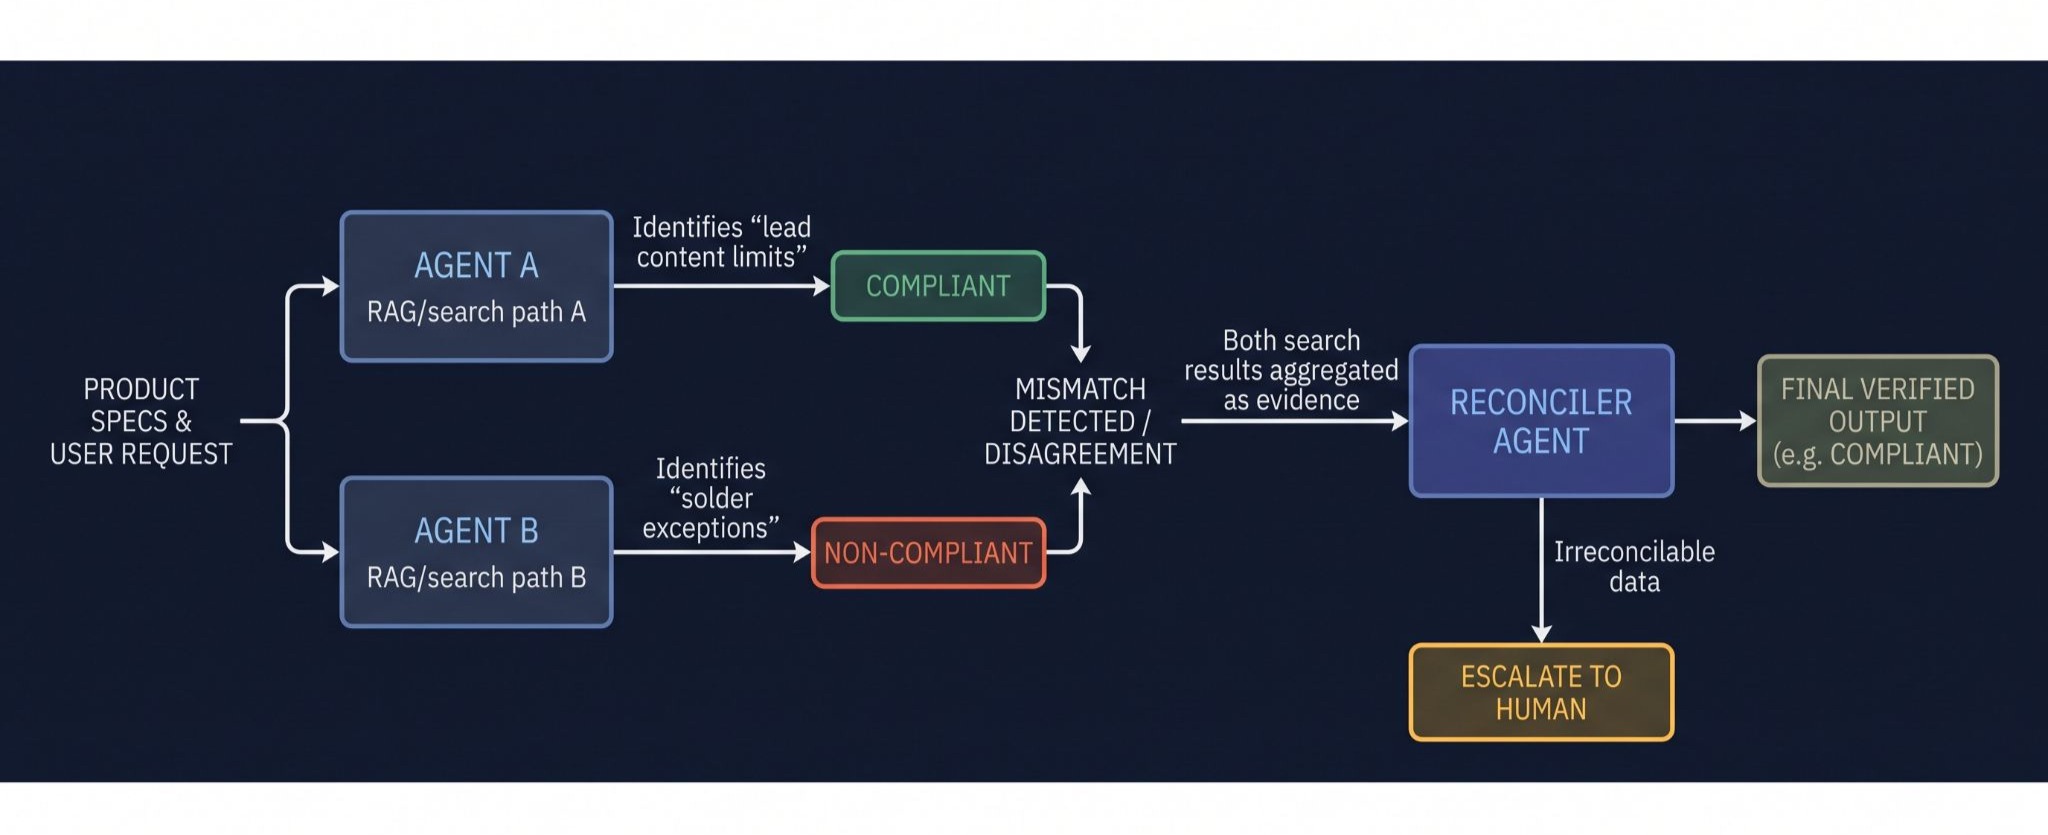
Kann der Reconciler die Uneinigkeit nicht auflösen, wird die Antwort trotzdem nie verworfen. Die Komponente erhält weiterhin eine vollständige Bewertung. Sie wird für die Prüfung durch einen Menschen gekennzeichnet und mit Begründungen versehen, etwa „Agenten uneinig über die Blei-Ausnahme“ oder „Datenblatt fehlt“. In diesem Design ist Uneinigkeit kein Fehler. Sie ist ein Mechanismus, der eine breitere Suche auslöst, und diese führt in der Regel zu einer robusteren, endgültigen Antwort. Außerdem ist sie ein stärkeres Signal für die Zuverlässigkeit, als selbst angegebene Konfidenzwerte, denn LLMs neigen dazu, sich zu überschätzen [11]. Übereinstimmung beweist zwar nicht, dass die Antwort richtig ist. Verwendet aber jeder Agent einen anderen Prompt, eine andere Retrieval-Strategie oder ein anderes Modell, wird es unwahrscheinlicher, dass beide denselben Fehler machen.
Betrieb wie bei Software: Observability und Evaluation
Jede Kontrollmaßnahme in diesem Artikel erzeugt Informationen: eine fehlgeschlagene Validierung, ein ausgeschöpftes Budget, Uneinigkeit zwischen Agenten, eine Aussage ohne Quelle. In einer Black Box verschwinden diese Signale in Logs, die niemand liest. Behandelt man sie als Engineering-Daten, zeigen sie klar, wie sich das System tatsächlich verhält. Dafür braucht es die Disziplin der klassischen Softwareentwicklung:
- Tracing: Für jeden Agenten- und Tool-Aufruf wird ein Span aufgezeichnet. Er enthält Eingaben, Ausgaben, Tokens und genutzte Runden und zeigt, ob der Agent sein Budget ausgeschöpft hat.
- Kostenabrechnung pro Durchlauf: Erfasst werden die LLM-Tokens und die Gebühren externer APIs, auch bei fehlgeschlagenen Durchläufen. Unbekannte Preise werden als unbekannt ausgewiesen, nicht als null.
- Evaluation der Zuverlässigkeit: Gemessen wird pass^k über wiederholte Durchläufe statt der Genauigkeit eines einzelnen Durchlaufs.
- Deterministische Tests: Das Modell wird gemockt, externe Anbieter werden über Fixtures abgebildet, und für alle Komponenten gibt es Unit-Tests. Beim Start prüft das System per Assertion, dass für jede akzeptierte Eingabe alles vorhanden ist, was nachgelagert benötigt wird (z. B. ein Regulierungsindex für jede unterstützte Region).
- Versionierung: Der Modell-Snapshot wird fest gepinnt, Prompts und Schemas werden versioniert, und jede Version wird in jedem Trace protokolliert.
Und schließlich ist Evaluation auch Handarbeit. Sehen Sie sich die Traces fehlgeschlagener oder unzuverlässiger Beispiele an, um genau zu erkennen, an welcher Stelle der Workflow gescheitert ist. Betrachten Sie Metriken als Signale, aber verzichten Sie nicht auf die manuelle Prüfung, auch wenn sie Zeit kostet. Gerade hier gewinnen Sie die wertvollsten Erkenntnisse.
Bei Kontrolle geht es darum, Fehler zu verstehen, nicht darum, sie zu vermeiden
Die in diesem Artikel beschriebenen Patterns machen Ihr Modell nicht klüger, aber sie machen es vertrauenswürdig. Mit ihnen wird das System ehrlich und bleibt bei Kosten und Laufzeit in festen Grenzen. Es legt seine Belege offen und macht seine Unsicherheiten sichtbar.
Wenn wir bei Merantix Momentum eine neue Pipeline von Grund auf entwerfen, stellen wir uns die folgenden 8 Fragen, um sicherzustellen, dass sie produktionsreif ist:
- Liegt der Kontrollfluss im Code oder im Prompt?
- Erzeugt das Modell Werte, die das System bereits kennt?
- Liefern die Tools gezielte Ausschnitte statt ganzer Dokumente?
- Gibt es Budgets, kennen die Agenten diese, und was passiert, wenn sie ausgeschöpft sind?
- Lässt sich jede Aussage in der Ausgabe auf einen belegten Fakt zurückführen?
- Wird jede überprüfbare Ausgabe im Code mit einer Ground Truth abgeglichen?
- Wird das Ergebnis gekennzeichnet, wenn Agenten uneinig sind oder die Konfidenz niedrig ist, oder wird es stillschweigend entschieden?
- Lässt sich jeder einzelne Durchlauf von Anfang bis Ende nachverfolgen, und ist bekannt, was er gekostet hat?
Einen Agenten zu kontrollieren heißt nicht, ihn einzuschränken. Es geht darum, jede Antwort nachvollziehbar zu machen, und eine falsche Antwort muss als falsch erkennbar sein. Der Harness, den Sie um das Modell herum bauen, macht den Unterschied zwischen einem beeindruckenden MVP, das nur im Idealfall funktioniert, und einem agentischen System auf Produktionsniveau, das robust, effizient und wartbar ist.
Quellen
1. Barres et al., 2025, τ²-Bench: Evaluating Conversational Agents in a Dual-Control Environment, arXiv:2506.07982
2. Sierra Research, τ²-bench leaderboard, https://taubench.com/leaderboard (accessed October 2026)
3. Cemri et al., 2025, Why Do Multi-Agent LLM Systems Fail?, arXiv:2503.13657
4. Yao et al., 2022, ReAct, arXiv:2210.03629
5. Wu et al., 2024, StateFlow, arXiv:2403.11322
6. Modarressi et al., 2025, NoLiMa: Long-Context Evaluation Beyond Literal Matching, arXiv:2502.05167
7. Hsieh et al., 2024, RULER: What's the Real Context Size of Your Long-Context Language Models?, arXiv:2404.06654
8. Cuadron et al., 2025, The Danger of Overthinking, arXiv:2502.08235
9. Liu et al., 2025, Budget-Aware Tool Use Enables Effective Agent Scaling, arXiv:2511.17006
10. Xiong et al., 2023, Can LLMs Express Their Uncertainty?, arXiv:2306.13063
11. Panickssery, Bowman & Feng, 2024, LLM Evaluators Recognize and Favor Their Own Generations, arXiv:2404.13076
Jetzt beim Merantix Momentum Newsletter anmelden.
Weitere Artikel


Vom Engpass zum Durchbruch: Warum KI entscheidend für den Fortschritt in Gesundheitswesen und Pharma ist

Von Black Box zu Glass Box: Wie sich KI-Agenten im Produktivbetrieb kontrollieren lassen
KI-Agenten verstehen und schlussfolgern inzwischen so gut, dass die Versuchung groß ist, ihnen ohne Weiteres die volle Kontrolle über Automatisierungssysteme zu überlassen. Agent-SDKs sind so ausgereift, dass sich mit einer langen Liste von Tools und umfangreichen Prompts innerhalb eines Tages eine Pipeline aufsetzen lässt. Diese Geschwindigkeit hat jedoch ihren Preis: Wer den Agenten die Schlüssel übergibt, übernimmt auch ihre Varianz.
Stellen Sie sich ein modernes Verkehrsflugzeug vor. Der Pilot fliegt, doch ein Flugcomputer hält das Flugzeug innerhalb eines sicheren Flugbereichs (Envelope). Agentische Systeme brauchen dieselbe Aufteilung: Das LLM ist der Pilot, der Code bildet den Envelope. Fehlt diese Trennung, treten zwei Probleme auf:
- Über wiederholte Durchläufe hinweg sinkt die Zuverlässigkeit. Auf τ²-bench [1], einem Benchmark, der mehrstufige Kundenservice-Aufgaben mit Tool-Nutzung simuliert, löst Claude Opus 4.5 dieselbe Retail-Aufgabe nur in etwa der Hälfte der Fälle bei allen vier Wiederholungen erfolgreich (pass^4: 51,8 %, Leaderboard abgerufen im Oktober 2026) [2].
- Multi-Agenten-Systeme scheitern auf vorhersehbare Weise. Eine Studie ordnete die Fehler 14 Kategorien und 3 Hauptgruppen zu: (i) Probleme im Systemdesign, (ii) mangelnde Abstimmung zwischen den Agenten und (iii) fehlende Verifikation der Aufgabe [3]. Die meisten davon sind Engineering-Probleme, keine Modellprobleme.
Um diese Fehler zu beheben, muss der Code den Workflow, die Eingaben, die Verifikation und den Umgang mit Unsicherheit verantworten, während das LLM für das Reasoning zuständig ist.
Diese Disziplin wird mitunter als Harness Engineering bezeichnet. Um beim Bild des Flugzeugs zu bleiben: Das Modell fliegt, der Harness ist alles drumherum: der Kontrollfluss, die Tools, die Prüfungen und feste Obergrenzen für Runden, Tool-Aufrufe und Kosten. Als Machine Learning Engineer bei Merantix Momentum bringe ich agentische Systeme aus der Sandbox in den realen Produktivbetrieb. Im Folgenden stelle ich acht Harness-Patterns vor, mit denen wir Kontrolle, Zuverlässigkeit und Sicherheit in solche Systeme einbauen.
Wie diese Patterns in der Praxis funktionieren, zeigen wir an einem anschaulichen Beispiel: einem Compliance-Agenten, der Hardwarekomponenten auf die Einhaltung regionaler Sicherheits- und Umweltstandards prüft. Einem LLM einfach die Produktspezifikationen und eine Gesetzesdatenbank zu übergeben, wäre riskant. Dieselbe Komponente könnte in einem Durchlauf als konform, und im nächsten als nicht konform eingestuft werden, jedes Mal mit einer überzeugend klingenden Begründung. Die folgenden Abschnitte zeigen Pattern für Pattern, wie sich das verhindern lässt.
Workflow statt Autonomie: deterministische Orchestrierung
Die erste Frage lautet: Kennen Sie den Ablauf des Workflows schon im Voraus? Bei offenen Aufgaben wie Recherche oder Debugging ist das meist nicht der Fall. Dort ist ein LLM-Orchestrator im Vorteil, der seine nächsten Schritte selbst plant und ausführt. Der Preis dafür ist weniger Vorhersagbarkeit, und Fehler sind schwerer zu erkennen. Lässt sich das Flussdiagramm dagegen schon vor dem Start zeichnen, bringt es nur unnötige Varianz, wenn das Modell den Ablauf bei jedem Durchlauf neu herleitet. In diesem Fall gilt: Die Übergänge zwischen den Stufen legt der Code fest, und innerhalb jeder Stufe hat der Agent begrenzten Spielraum. Zwei Designs eignen sich dafür:
- Ein Directed-Acyclic-Graph Workflow (DAG) legt den Kontrollfluss über statische Knoten und Kanten deterministisch fest. Er eignet sich hervorragend für vorhersehbare oder lineare Pipelines, etwa eine klassische Retrieval-Augmented-Generation-Pipeline (RAG).
- Eine Finite-State Machine (FSM) erlaubt Zyklen zwischen Zuständen, sobald bestimmte Bedingungen erfüllt sind. Das ermöglicht Iterationen, Fehlerkorrektur und Retry-Schleifen für teilautonome Agenten.
Im Compliance-Agenten verhindert eine FSM, dass das LLM von seiner Aufgabe abweicht. Wir definieren feste Zustände: Extract_Materials -> Retrieve_Regulations -> Assess_Compliance. Innerhalb eines Zustands schlussfolgert das LLM und darf iterieren. Über die Übergänge entscheidet jedoch der deterministische Code, anhand validierter Felder in den Ausgaben des Modells.
Fachliteratur und Benchmark-Aufgaben zeigen, dass der Wechsel von einer rein stochastischen ReAct-Schleife (Reason + Act) [4] zu einer FSM-Architektur die Erfolgsquote bei realen Workflows deutlich steigert und gleichzeitig die Kosten senkt. Das StateFlow-Framework [5] erzielte bei Decision-Making-Aufgaben eine um 28 % höhere Erfolgsquote und bei der Code-/Datenausführung eine um 13 % höhere Erfolgsrate, bei 3- bzw. 5-mal niedrigeren Kosten. Ein weiterer Vorteil fester Stufen: sie lassen sich einzeln testen und debuggen, wodurch das System deutlich leichter wartbar wird.
Den Handlungsspielraum begrenzen: Der Agent entscheidet, was passiert; der Code entscheidet, wo
Statische Stufen und Übergänge geben uns die Kontrolle über die Umgebung. Sie garantieren jedoch nicht, dass der Agent die Bedingungen für seine Aktionen korrekt erfüllt. Aktionen lösen Übergänge auf Basis der strukturierten Ausgabe des LLM aus, und diese kann falsch formatiert sein oder über den erwarteten Handlungsspielraum hinausgehen. Füllt ein LLM die Tool-Parameter selbst aus, kann es einen ungültigen Wert vorschlagen oder, schlimmer noch, einen gültigen, aber falschen Wert (z. B. Region UK statt EU). Dann scheitert das System, ohne dass es jemand bemerkt.
Der Code muss kontrollieren, was das LLM verwenden darf. Beim Compliance-Agenten bestimmt das Modell Region und Schweregrad nicht selbst, wenn es eine Komponente beanstandet. Stattdessen setzen wir gezielte Schutzmechanismen ein:
- Parameter Binding: Parameter (Region: EU) werden direkt aus der Anfrage übergeben. Das Modell sollte niemals einen Wert erzeugen, den das System bereits kennt.
- Tool-Scoping nach dem Least-Privilege-Prinzip: Jeder Agent erhält nur die kleinstmögliche Auswahl an Tools, die er in seinem aktuellen Zustand benötigt.
- Auswahl aus festen Werten: Das Ergebnis wird als Enum deklariert ((COMPLIANT, NON_COMPLIANT, NEEDS_REVIEW) und über Structured Outputs erzwungen. So kann das Modell keinen Wert außerhalb dieser Menge erzeugen.
Mit diesen Design-Patterns gibt es weniger unbemerkte Fehler und eine kleinere Angriffsfläche. Außerdem lassen sich verbleibende Fehler direkt dem Reasoning des Modells zuordnen statt der technischen Anbindung.
Context Engineering: Geben Sie Ihrem Agenten die relevanten Informationen
Kontextfenster sind enorm gewachsen. Selbst günstige Modelle wie Claude Haiku 5.5 verarbeiten inzwischen 1 Million Input-Tokens. Daraus entsteht eine gefährliche Versuchung: einfach alle verfügbaren Informationen in den Kontext zu laden und das Modell die Nadel im Heuhaufen suchen zu lassen. Das beworbene Kontextfenster ist jedoch nicht das nutzbare. Auf NoLiMa [6] erreichen die meisten der 12 getesteten Long-Context-Modelle schon bei 32.000 Tokens weniger als die Hälfte ihres Ergebnisses mit kurzem Kontext. Selbst GPT-4o fällt von 99,3 % auf 69,7 %. RULER [7] stellt dieselbe Lücke zwischen angegebener und tatsächlich nutzbarer Kontextlänge fest.
Beim Compliance-Agenten heißt die Prüfung auf beschränkte Stoffe nicht, ihm das gesamte EU-Recht mitzugeben. Stattdessen koppeln wir ihn an ein Retrieval-Tool, das speziell für juristische Texte entwickelt wurde. Dasselbe Prinzip lässt sich auf andere Tool-Aufrufe übertragen, etwa auf die Websuche. Statt den vollständigen Seiteninhalt mit 50.000 Tokens zurückzugeben, liefert das Tool nur Textausschnitte rund um bestimmte Produktmerkmale (z. B. „Bleigehalt im Lot“), die der Agent als Suchbegriffe gewählt hat. Das Ergebnis: weniger Tokens pro Aufruf, weniger Störinformationen, die das Modell fehlinterpretieren könnte, und reproduzierbare Extraktionen.
Begrenzte Autonomie: Budget und Sicherheitsnetz
Bei Interaktionen über viele Runden hinweg kann die Leistung eines Agenten nachlassen. Neben Halluzinationen und dem Verlorengehen in langen Kontexten neigt ein LLM zum Overthinking: Es gibt internen Überlegungen den Vorrang vor konkreten Aktionen. Trajektorien mit wenig Overthinking erzielen dagegen schätzungsweise rund 30 % bessere Ergebnisse bei 43 % weniger Rechenaufwand [8].
Angenommen, der Lieferant hat für einen Kondensator, den der Compliance-Agent gerade prüft, nie ein Datenblatt veröffentlicht. Ohne Grenzen könnte der Compliance-Agent sein gesamtes Kontextfenster aufbrauchen, weil er immer wieder nach einer Information sucht, die es schlicht nicht gibt. Ein konkretes Ziel ist daher, die Zahl der Iterationen pro Agent durch klare Grenzen zu reduzieren:
- Rundenbudget mit Hinweis auf die letzte Runde: Die Zahl der Runden, die der Agent nutzen darf, wird begrenzt. Ein Hinweis vor der letzten Runde stellt sicher, dass der Agent ein vollständiges Ergebnis liefert, bevor der harte Abbruch greift.
- Budgetbewusste Tool-Nutzung: Für jedes Tool gilt ein Aufruflimit, und das verbleibende Budget wird in jeder Runde angezeigt. Das bringt den Agenten dazu, seine Strategie zu optimieren [9].
- Finalizer-Agent: Er dient als Sicherheitsnetz. Gehen dem Compliance-Agenten bei der Suche nach dem fehlenden Datenblatt die Runden aus, übernimmt der Finalizer, fasst die vorhandenen Belege zusammen und beendet den Workflow kontrolliert.
Diese Leitplanken begrenzen nicht nur Overthinking und senken die Kosten, sie geben auch Kontrolle über Latenz und Ausgaben pro Durchlauf, und jeder Durchlauf endet mit einem verwertbaren Ergebnis.
Reasoning strukturieren: Belege vor Antworten
Häufig wird angenommen, das Reasoning eines LLM sei eine Black Box: Den Prompt kann man anpassen, das Denken selbst nicht. Dabei wird ein Hebel oft übersehen, mit dem sich das Reasoning direkt beeinflussen lässt: Output-Schemas.
Format und Vollständigkeit der Ausgabe sind für agentisches Reasoning entscheidend. Beim Compliance-Agenten ist kein Ergebnis möglich, solange die Belege nicht aufgeführt sind. Vor der Schlussfolgerung verlangt das Output-Schema die genaue Rechtsvorschrift (z. B. Artikel 4 Absatz 1) und die passende Materialspezifikation. Das Modell muss also erst die Belege in seinem Kontext finden, bevor es zu einem Urteil kommen kann.
Eine strukturierte Liste gefundener Fakten im Output-Schema zwingt das LLM, in seinem Kontext nach Belegen zu suchen. Als Zusatznutzen entsteht so sofort ein Audit-Trail für menschliche Prüfer. Auf dem ELI5-Benchmark von ALCE fehlt selbst den besten Modellen in 50 % der Fälle eine vollständige Stützung durch Quellenangaben [10]. Zitiert ein Agent eine Quelle oder ein Tool, das er während des Durchlaufs nie abgefragt hat, kann das System dies sofort als erfundenen Beleg kennzeichnen.
Verifikation außerhalb des Modells: Vertrauen ist gut, Kontrolle im Code ist besser
LLMs bewerten ihre eigenen Ausgaben tendenziell besser [11], und Selbstkritik kann die Leistung sogar verschlechtern. Auch ein zweites Modell verhindert nicht, dass derselbe Denkfehler oder dieselbe Datenlücke erneut auftritt. Setzen Sie deshalb immer auf eine belastbare externe Verifikation, etwa einen Abgleich mit Referenzdaten als Ground Truth, deterministische Korrekturen oder Schema-Validatoren.
Beim Compliance-Agenten erhält jeder Verstoß eine Risiko-ID, die in der offiziellen Risikotaxonomie nachgeschlagen wird. Halluziniert das LLM einen nicht existierenden Code, fängt ihn der deterministische Code-Validator ab. Daraufhin wird genau ein korrigierender Neuversuch ausgelöst, bei dem die nächstliegenden gültigen Optionen aufgelistet werden. Ist auch der korrigierte Code ungültig, wird der halluzinierte Code mit einem Fallback-Wert gekennzeichnet, bevor er unbemerkt in nachgelagerte Systeme gelangt. Kann die Prüfung selbst nicht ausgeführt werden (Ladefehler, Timeout), gilt das Ergebnis als „nicht verifiziert“: ein dritter Zustand, der sich sowohl von „bestanden“ als auch von „nicht bestanden“ unterscheidet.
Varianz als Signal nutzen: Konsens und kalibrierte Unsicherheit
Varianz zwischen verschiedenen Durchläufen gilt oft als Rauschen oder als Zeichen dafür, dass ein Ergebnis unsicher ist. Richtig genutzt zeigt sie jedoch, wie verlässlich ein Ergebnis ist und welche Fälle ein Mensch prüfen sollte.
Die erste Möglichkeit, diese Varianz zu nutzen, ist ein Mehrheitsentscheid im Sinne der „Weisheit der Vielen“. Erzeugt man in parallelen Durchläufen mehrere Antworten und führt die Ergebnisse zusammen, steigt die Zuverlässigkeit und es gibt weniger Halluzinationen. Allerdings vervielfachen sich dadurch die Kosten, und bei einem systematischen Fehler ist eine hohe Genauigkeit trotzdem nicht garantiert.
Günstiger sind Redundanz und Abgleich. Beim Compliance-Agenten prüfen zwei Bewertungsagenten parallel dieselbe Komponente. Jeder Agent formuliert seine eigenen Tool-Abfragen und schlägt damit einen anderen Weg ein. Der eine sucht nach „Grenzwerte für Bleigehalt“, der andere nach „Ausnahmen für Lote“, und womöglich kommen sie zu unterschiedlichen Schlüssen. Sind sie sich uneinig, übernimmt ein Reconciler-Agent. Er wertet die Belege beider Agenten gemeinsam aus und nimmt eine neue Klassifizierung vor. Damit unterscheidet sich der Reconciler grundlegend von einem Modell, das eine bereits vorliegende Antwort nur noch einmal bewertet: Er stützt sich auf die Belege aus zwei unabhängigen Suchwegen und hat damit mehr Informationen als jeder der beiden Agenten allein.
Kann der Reconciler die Uneinigkeit nicht auflösen, wird die Antwort trotzdem nie verworfen. Die Komponente erhält weiterhin eine vollständige Bewertung. Sie wird für die Prüfung durch einen Menschen gekennzeichnet und mit Begründungen versehen, etwa „Agenten uneinig über die Blei-Ausnahme“ oder „Datenblatt fehlt“. In diesem Design ist Uneinigkeit kein Fehler. Sie ist ein Mechanismus, der eine breitere Suche auslöst, und diese führt in der Regel zu einer robusteren, endgültigen Antwort. Außerdem ist sie ein stärkeres Signal für die Zuverlässigkeit, als selbst angegebene Konfidenzwerte, denn LLMs neigen dazu, sich zu überschätzen [11]. Übereinstimmung beweist zwar nicht, dass die Antwort richtig ist. Verwendet aber jeder Agent einen anderen Prompt, eine andere Retrieval-Strategie oder ein anderes Modell, wird es unwahrscheinlicher, dass beide denselben Fehler machen.
Betrieb wie bei Software: Observability und Evaluation
Jede Kontrollmaßnahme in diesem Artikel erzeugt Informationen: eine fehlgeschlagene Validierung, ein ausgeschöpftes Budget, Uneinigkeit zwischen Agenten, eine Aussage ohne Quelle. In einer Black Box verschwinden diese Signale in Logs, die niemand liest. Behandelt man sie als Engineering-Daten, zeigen sie klar, wie sich das System tatsächlich verhält. Dafür braucht es die Disziplin der klassischen Softwareentwicklung:
- Tracing: Für jeden Agenten- und Tool-Aufruf wird ein Span aufgezeichnet. Er enthält Eingaben, Ausgaben, Tokens und genutzte Runden und zeigt, ob der Agent sein Budget ausgeschöpft hat.
- Kostenabrechnung pro Durchlauf: Erfasst werden die LLM-Tokens und die Gebühren externer APIs, auch bei fehlgeschlagenen Durchläufen. Unbekannte Preise werden als unbekannt ausgewiesen, nicht als null.
- Evaluation der Zuverlässigkeit: Gemessen wird pass^k über wiederholte Durchläufe statt der Genauigkeit eines einzelnen Durchlaufs.
- Deterministische Tests: Das Modell wird gemockt, externe Anbieter werden über Fixtures abgebildet, und für alle Komponenten gibt es Unit-Tests. Beim Start prüft das System per Assertion, dass für jede akzeptierte Eingabe alles vorhanden ist, was nachgelagert benötigt wird (z. B. ein Regulierungsindex für jede unterstützte Region).
- Versionierung: Der Modell-Snapshot wird fest gepinnt, Prompts und Schemas werden versioniert, und jede Version wird in jedem Trace protokolliert.
Und schließlich ist Evaluation auch Handarbeit. Sehen Sie sich die Traces fehlgeschlagener oder unzuverlässiger Beispiele an, um genau zu erkennen, an welcher Stelle der Workflow gescheitert ist. Betrachten Sie Metriken als Signale, aber verzichten Sie nicht auf die manuelle Prüfung, auch wenn sie Zeit kostet. Gerade hier gewinnen Sie die wertvollsten Erkenntnisse.
Bei Kontrolle geht es darum, Fehler zu verstehen, nicht darum, sie zu vermeiden
Die in diesem Artikel beschriebenen Patterns machen Ihr Modell nicht klüger, aber sie machen es vertrauenswürdig. Mit ihnen wird das System ehrlich und bleibt bei Kosten und Laufzeit in festen Grenzen. Es legt seine Belege offen und macht seine Unsicherheiten sichtbar.
Wenn wir bei Merantix Momentum eine neue Pipeline von Grund auf entwerfen, stellen wir uns die folgenden 8 Fragen, um sicherzustellen, dass sie produktionsreif ist:
- Liegt der Kontrollfluss im Code oder im Prompt?
- Erzeugt das Modell Werte, die das System bereits kennt?
- Liefern die Tools gezielte Ausschnitte statt ganzer Dokumente?
- Gibt es Budgets, kennen die Agenten diese, und was passiert, wenn sie ausgeschöpft sind?
- Lässt sich jede Aussage in der Ausgabe auf einen belegten Fakt zurückführen?
- Wird jede überprüfbare Ausgabe im Code mit einer Ground Truth abgeglichen?
- Wird das Ergebnis gekennzeichnet, wenn Agenten uneinig sind oder die Konfidenz niedrig ist, oder wird es stillschweigend entschieden?
- Lässt sich jeder einzelne Durchlauf von Anfang bis Ende nachverfolgen, und ist bekannt, was er gekostet hat?
Einen Agenten zu kontrollieren heißt nicht, ihn einzuschränken. Es geht darum, jede Antwort nachvollziehbar zu machen, und eine falsche Antwort muss als falsch erkennbar sein. Der Harness, den Sie um das Modell herum bauen, macht den Unterschied zwischen einem beeindruckenden MVP, das nur im Idealfall funktioniert, und einem agentischen System auf Produktionsniveau, das robust, effizient und wartbar ist.
Quellen
1. Barres et al., 2025, τ²-Bench: Evaluating Conversational Agents in a Dual-Control Environment, arXiv:2506.07982
2. Sierra Research, τ²-bench leaderboard, https://taubench.com/leaderboard (accessed October 2026)
3. Cemri et al., 2025, Why Do Multi-Agent LLM Systems Fail?, arXiv:2503.13657
4. Yao et al., 2022, ReAct, arXiv:2210.03629
5. Wu et al., 2024, StateFlow, arXiv:2403.11322
6. Modarressi et al., 2025, NoLiMa: Long-Context Evaluation Beyond Literal Matching, arXiv:2502.05167
7. Hsieh et al., 2024, RULER: What's the Real Context Size of Your Long-Context Language Models?, arXiv:2404.06654
8. Cuadron et al., 2025, The Danger of Overthinking, arXiv:2502.08235
9. Liu et al., 2025, Budget-Aware Tool Use Enables Effective Agent Scaling, arXiv:2511.17006
10. Xiong et al., 2023, Can LLMs Express Their Uncertainty?, arXiv:2306.13063
11. Panickssery, Bowman & Feng, 2024, LLM Evaluators Recognize and Favor Their Own Generations, arXiv:2404.13076


