Active Learning in DeepRod für granulare Verhaltensphänotypen

Unser Paper „Active learning in DeepRod enables efficient discovery of granular behavioral phenotypes“ ist in Current Research in Behavioral Sciences erschienen.
Was ist heute die größte Herausforderung in der angewandten ML-Forschung? Methoden so zu validieren, dass ihr Nutzen im echten Leben sichtbar wird, und nicht nur gute Kennzahlen auf Benchmarks. Gerade im Gesundheitswesen und in der Arzneimittelentwicklung ist das entscheidend. , sondern den, der Patientinnen und Patienten wirklich hilft. Und das erkennen wir an echten Ergebnissen: höhere Überlebensraten, frühere Diagnosen, weniger Wirkstoffe, die erst spät in der Entwicklung scheitern, und.
Genau darum geht es in unserem kürzlich veröffentlichten Paper zu fortgeschrittenem Active Learning für die automatisierte Verhaltensanalyse. Einen Chatbot haben wir nicht. Wir haben ein Computer-Vision-System, das die Verhaltensphänotypisierung von Nagetieren in pharmakologischen Studien automatisiert. Das Problem: Präklinische Verhaltensstudien liefern pro Tier 14 bis 24 Stunden Videomaterial. Die manuelle Annotation ist dabei ein Bottleneck. Unsere Plattform DeepRod automatisiert diesen Schritt. Aber automatisierte Modelle brauchen Trainingsdaten, und das Annotieren von Verhaltensszenen ist genau die Expertenarbeit, die man eigentlich reduzieren möchte.
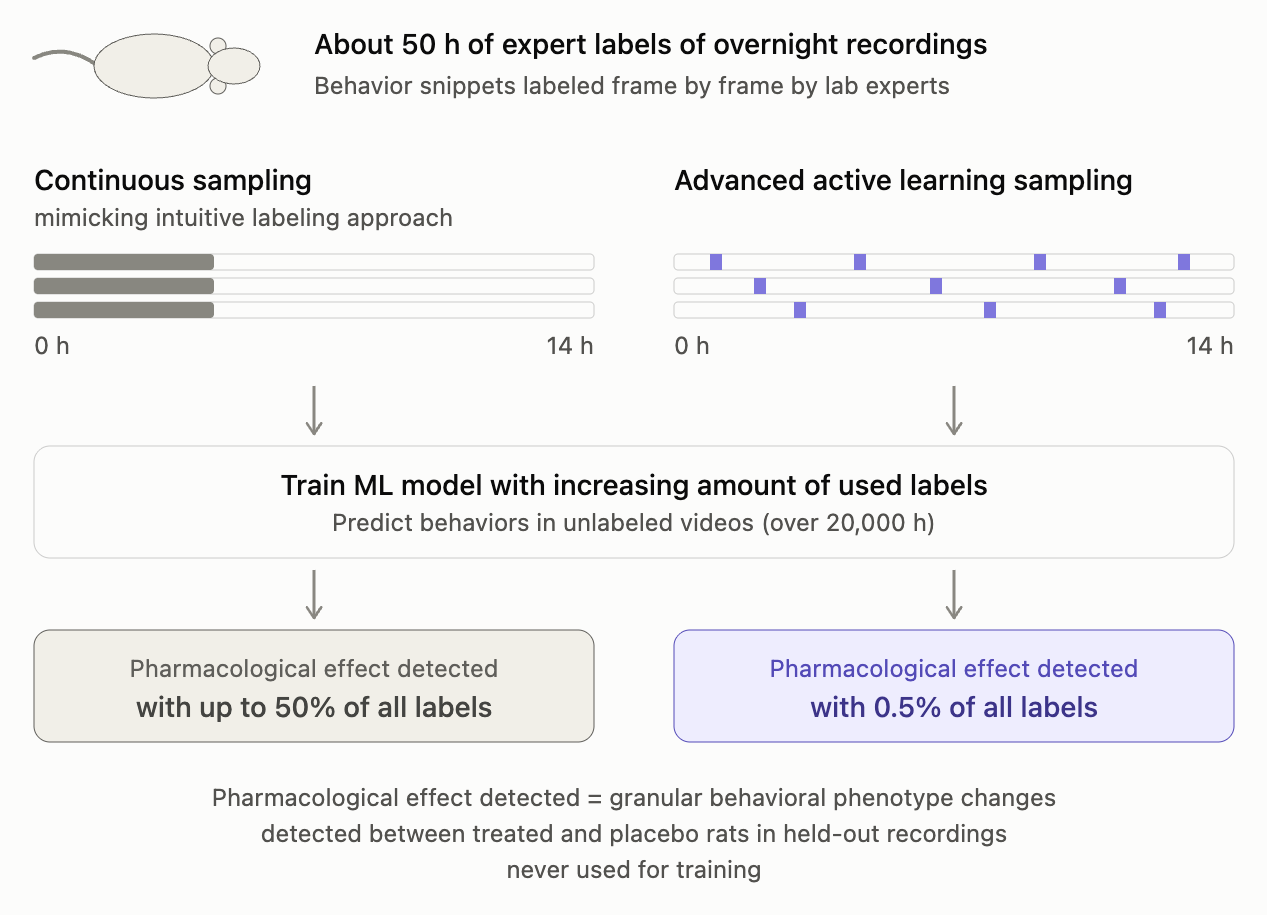
Fortgeschrittene Active-Learning-Methoden lösen dieses Problem, indem sie nur die aussagekräftigsten Beispiele zum Annotieren auswählen. Wir haben nicht nur gezeigt, dass sich damit die Klassifikationsgenauigkeit verbessert. Wir haben gezeigt: Ein Modell, das mit nur 0,5 Prozent des gesamten Label-Pools trainiert wurde, erkennt trotzdem statistisch signifikante, medikamentös ausgelöste Verhaltensänderungen, und zwar genau dieselben Effekte wie das vollständig trainierte Referenzmodell. Das gilt auch für feine Unterscheidungen wie Apathie und Schlaf unter Clonidin-Behandlung, die gröbere Methoden einfach in einen Topf werfen.
Das Fazit lautet also nicht nur: „Das Modell ist genau.“ Sondern: Das Modell ist genau, und die pharmakologischen Schlussfolgerungen stimmen weiterhin.
Ohne enge Zusammenarbeit wäre das unmöglich gewesen. Die Forschenden bei Boehringer Ingelheim haben nicht nur Daten beigesteuert, sondern mitdefiniert, was im präklinischen Kontext überhaupt ein relevantes Ergebnis ist. Das Active Learning sucht jetzt ganz gezielt nach Grenzfällen zwischen eng verwandten Verhaltensweisen – weil es in der Praxis genau auf diese Unterscheidungen ankommt.
Genau das bauen wir bei Merantix Momentum: ML, das an echten Ergebnissen validiert wird, nicht nur an Benchmarks. Entwickelt gemeinsam mit den Menschen, die ihr Fachgebiet gut genug kennen, um zu definieren, welche Ergebnisse wirklich zählen.
Jetzt beim Merantix Momentum Newsletter anmelden.
Weitere Artikel



Active Learning in DeepRod für granulare Verhaltensphänotypen
Unser Paper „Active learning in DeepRod enables efficient discovery of granular behavioral phenotypes“ ist in Current Research in Behavioral Sciences erschienen.
Was ist heute die größte Herausforderung in der angewandten ML-Forschung? Methoden so zu validieren, dass ihr Nutzen im echten Leben sichtbar wird, und nicht nur gute Kennzahlen auf Benchmarks. Gerade im Gesundheitswesen und in der Arzneimittelentwicklung ist das entscheidend. , sondern den, der Patientinnen und Patienten wirklich hilft. Und das erkennen wir an echten Ergebnissen: höhere Überlebensraten, frühere Diagnosen, weniger Wirkstoffe, die erst spät in der Entwicklung scheitern, und.
Genau darum geht es in unserem kürzlich veröffentlichten Paper zu fortgeschrittenem Active Learning für die automatisierte Verhaltensanalyse. Einen Chatbot haben wir nicht. Wir haben ein Computer-Vision-System, das die Verhaltensphänotypisierung von Nagetieren in pharmakologischen Studien automatisiert. Das Problem: Präklinische Verhaltensstudien liefern pro Tier 14 bis 24 Stunden Videomaterial. Die manuelle Annotation ist dabei ein Bottleneck. Unsere Plattform DeepRod automatisiert diesen Schritt. Aber automatisierte Modelle brauchen Trainingsdaten, und das Annotieren von Verhaltensszenen ist genau die Expertenarbeit, die man eigentlich reduzieren möchte.
Fortgeschrittene Active-Learning-Methoden lösen dieses Problem, indem sie nur die aussagekräftigsten Beispiele zum Annotieren auswählen. Wir haben nicht nur gezeigt, dass sich damit die Klassifikationsgenauigkeit verbessert. Wir haben gezeigt: Ein Modell, das mit nur 0,5 Prozent des gesamten Label-Pools trainiert wurde, erkennt trotzdem statistisch signifikante, medikamentös ausgelöste Verhaltensänderungen, und zwar genau dieselben Effekte wie das vollständig trainierte Referenzmodell. Das gilt auch für feine Unterscheidungen wie Apathie und Schlaf unter Clonidin-Behandlung, die gröbere Methoden einfach in einen Topf werfen.
Das Fazit lautet also nicht nur: „Das Modell ist genau.“ Sondern: Das Modell ist genau, und die pharmakologischen Schlussfolgerungen stimmen weiterhin.
Ohne enge Zusammenarbeit wäre das unmöglich gewesen. Die Forschenden bei Boehringer Ingelheim haben nicht nur Daten beigesteuert, sondern mitdefiniert, was im präklinischen Kontext überhaupt ein relevantes Ergebnis ist. Das Active Learning sucht jetzt ganz gezielt nach Grenzfällen zwischen eng verwandten Verhaltensweisen – weil es in der Praxis genau auf diese Unterscheidungen ankommt.
Genau das bauen wir bei Merantix Momentum: ML, das an echten Ergebnissen validiert wird, nicht nur an Benchmarks. Entwickelt gemeinsam mit den Menschen, die ihr Fachgebiet gut genug kennen, um zu definieren, welche Ergebnisse wirklich zählen.


