Perspektiven aus der Praxis: Wie KI-Agenten außerhalb der Demo tatsächlich aussehen

Von Marcel Weigand, Senior AI Solutions Architect bei Merantix Momentum
Es gibt eine Version von KI-Agenten, die auf Keynote-Slides lebt, und eine Version, die in der Produktion lebt. Das sind keineswegs dieselben Systeme und so zu tun, als ob sie es wären, ist einer der kostspieligen Fehler, die ich derzeit bei Unternehmen beobachte. In einer Demo-Version nimmt ein Agent eine Anfrage in natürlicher Sprache entgegen, wägt die Nutzung mehrerer Tools ab und liefert eine saubere Antwort. In der Produktionsversion muss sich derselbe Agent mit fehlerhaften Eingaben, halb defekten vorgelagerten Pipelines, berechtigten Daten, die er nicht einsehen kann, Zeitüberschreitungen bei Tools und einem Auditor auseinandersetzen, der genau wissen möchte, warum der Agent an einem Dienstag um 03:14 Uhr genau das gesagt hat, was er gesagt hat.
Alles, was ich hier teilen möchte, stammt aus dieser zweiten Welt. Die Lücke zwischen einer Demo und der Produktion ist real, breit und tritt immer wieder auf. Doch entgegen der landläufigen Meinung ist das Modell selten der Flaschenhals: Wenn ein Kundenprojekt ins Stocken gerät, liegt das fast nie daran, dass das LLM nicht intelligent genug ist, sondern daran, dass die Systemarchitektur falsch ausgerichtet ist, die Entwicklerkultur am Nicht-Determinismus scheitert oder Evaluierungsschleifen in der Produktion fehlen. In diesem Reifestadium bringt es nichts, ein Frontier-Modell durch ein anderes zu ersetzen. Der Großteil der Arbeit bei der Bereitstellung eines Agenten ist organisatorischer und architektureller Natur, nicht algorithmischer.
1. Architektur: Sind Agenten überhaupt das richtige System?
Die erste architekturelle Frage, die es zu beantworten gilt, ist, ob Sie überhaupt einen Agenten bauen sollten. Ingenieursdisziplin beginnt damit, zu bewerten, ob ein Agenten-Setup wirklich notwendig ist, anstatt es standardmäßig vorauszusetzen. Ein Großteil der Anfragen der Kategorie „Wir brauchen einen KI-Agenten“ erweist sich als Standard-Workflow mit einem einzigen unscharfen Schritt. Das Extrahieren von Feldern aus einer Rechnung oder das Klassifizieren eines Support-Tickets erfordert keinen Agenten. Dies sind lineare Pipelines, bei denen ein LLM unstrukturierte Texte verarbeitet und traditionelle Software den Rest erledigt.
Ein Agent ist dann die richtige Architektur, wenn der Pfad selbst variabel ist. Das bedeutet, dass das System während der Laufzeit tatsächlich entscheiden muss, was als Nächstes zu tun ist, welche Tools in welcher Reihenfolge aufgerufen werden sollen und zwar basierend auf dem, was es gerade gelernt hat. Das betrifft eine weit kleinere Gruppe von Problemen, als der aktuelle Diskurs vermuten lässt. Die Fehlklassifizierung eines Workflows als Agent bringt reale Kosten mit sich: höhere Latenz, höhere Ausgaben, erschwertes Testen, schwierigeres Debugging und weniger Vorhersehbarkeit, was besonders dann zählt, wenn der Nutzer ein zahlender Kunde oder eine Regulierungsbehörde ist.
Ein nützlicher Weg, um herauszufinden, in welcher Situation Sie sich befinden, ist die Beantwortung von vier Fragen zum Prozess:
- Handelt es sich bei der Eingabe um strukturierte Daten oder um unstrukturierte, komplexe natürliche Sprache?
- Ist die Abfolge der Schritte festgelegt oder muss das System diese je nach Situation entscheiden?
- Ist fest codiert, welche externen Systeme aufgerufen werden, oder muss das System wählen?
- Und was kostet ein Fehler? Ist er günstig und korrigierbar oder teuer und unumkehrbar?
Je mehr diese Aspekte in Richtung „variabel“ und „teuer“ tendieren, desto eher rechtfertigt ein Agent seinen Preis. Geht man die Liste ehrlich durch, ordnet man ein gegebenes Problem öfter als gedacht weiter links ein, als die ursprüngliche Anforderung vermuten ließ.
Gelangt man zu dem Schluss, dass tatsächlich ein Agent benötigt wird, ist der Reflex, einen Agenten zu bauen, der alles kann, meist immer noch falsch. Kleine Agenten mit eng gestecktem Rahmen lassen sich leichter evaluieren, debuggen, sichern und ihnen fällt es leichter, Vertrauen aufzubauen. Bevor Sie irgendetwas bauen, berücksichtigen Sie ein zentrales Szenario: Was ist das Schlimmste, was dieser Agent plausiblerweise tun könnte? Da kleinere Agenten definierbarere und begrenzte Fehlermöglichkeiten haben, prägt die Identifizierung dieses Worst-Case-Szenarios direkt Ihre Tool-Grenzen. So entwickeln Sie schrittweise verlässliche Systeme, die gezielt auf Fehlerminimierung ausgelegt sind und auch in regulierten Bereichen sicher eingesetzt werden können.
2. Kultur & Nicht-Determinismus: Nicht-Determinismus bricht Ihre Entwicklerkultur
Selbst mit der richtigen Architektur tritt die nächste erschwerende Herausforderung auf: Ihr Entwicklungsteam ist selten darauf vorbereitet, wie sich nicht-deterministische Systeme verhalten. Softwareteams haben dreißig Jahre lang Gewohnheiten rund um deterministische Systeme aufgebaut: Code schreiben, Test schreiben, grüner Build, Deployment. Agenten verhalten sich nicht so. Derselbe Prompt kann unterschiedliche Ergebnisse liefern. Ein Tool-Aufruf, der zweimal erfolgreich war, kann beim dritten Mal auf eine Weise fehlschlagen, die schwer zu reproduzieren ist. Traditionelle CI- und Incident-Response setzen ein Maß an Reproduzierbarkeit voraus, das schlichtweg nicht gegeben ist.
Das erzwingt einen kulturellen Wandel, den Teams oft unterschätzen. Sie brauchen Entwickler, die in Verteilungen statt in Zusicherungen (Assertions) denken; Produktmanager, die Erfolg als „akzeptables Verhalten über eine Vielzahl von Interaktionen hinweg“ definieren; und eine Führungsebene, die akzeptiert, dass Fehler bis zu einem gewissen Grad normal sind, ohne bei jeder kleinen Abweichung direkt den Notfall auszurufen.
Dieser kulturelle Wandel speist direkt die letzte Komplexitätsebene: die Evaluierung. Sobald Sie Verteilungen statt fixer Zusicherungen ausliefern, kann die Frage, ob das System gut genug ist, nicht mehr statisch während der Entwicklung gelöst werden. Stattdessen erfordert sie eine kontinuierliche Schleife in der Produktion.
3. Evaluierung: Die Lücke, die Sie während der Entwicklung nicht schließen können
Die Evaluierung hat ein zugrunde liegendes epistemisches Problem: Sie können während der Entwicklung nicht an alle Sonderfälle denken, weil Sie noch nicht wissen, was echte Nutzer tun werden. Testfälle decken die Situationen ab, die Sie sich vorstellen können und diese neigen dazu, genau die Szenarien zu bevorzugen, die das System bereits gut beherrscht.
Synthetische Testsets helfen, aber nur bis zu einem gewissen Grad. Ein Ansatz besteht darin, in einem Workshop mit einem Fachexperten die zugrunde liegenden Geschäftsregeln und eine kleine Gruppe realer Beispiele zu erfassen und daraus ein weit größeres synthetisches Testset zu generieren. Der Agent läuft dagegen an und die Ergebnisse werden in drei Ebenen geprüft: deterministische Zusicherungen für alles mit einer klaren richtigen Antwort, ein LLM-as-a-Judge für unschärfere Fälle und nur die wirklich ungewissen Ergebnisse werden an den Fachexperten weitergeleitet. Alles andere evaluiert das System selbst.
Die zwei Schleifen und die Rolle des Fachexperten darin sehen wie folgt aus:
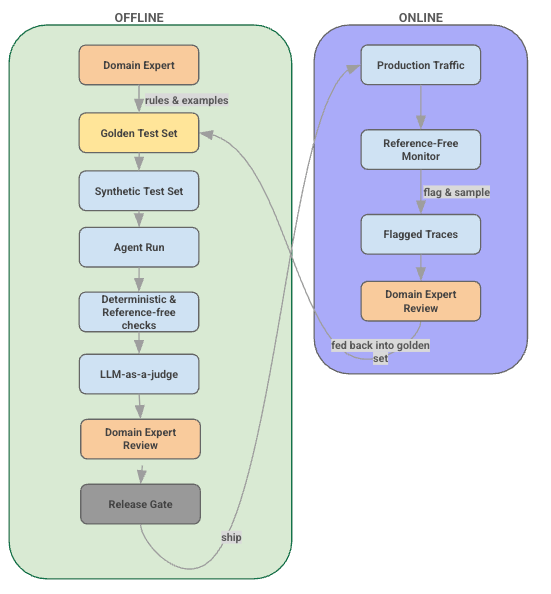
Die rechte Hälfte des Diagramms verhindert, dass die Offline-Evaluierung veraltet ist. Reale Nutzer werden immer Fälle finden, an die niemand im Vorhinein gedacht hat. Deshalb brauchen Sie die zweite Schleife, die kontinuierlich in der Produktion läuft: referenzfreie Prüfungen des Live-Traffics, die Fundierung, Sicherheit und Selbstkonsistenz abdecken und keine Referenzantwort benötigen, um ausgeführt zu werden; plus ein kleiner Strom von markierten und gesampelten Spuren (Traces), die überprüft und in das Referenzset zurückgeführt werden. Das nächste Release läuft gegen das verbesserte Set. Ohne diese Schleife driftet die Offline-Evaluierung stillschweigend von dem ab, was bei realen Nutzern tatsächlich passiert.
Damit all das funktioniert, ist eine ordentliche Observability erforderlich: Transparenz auf Trace-Ebene in jeden Prompt, jeden Abruf, jeden Tool-Aufruf und jeden erneuten Versuch (Retry) sowie die Möglichkeit, eine vollständige Sitzung von Anfang bis Ende erneut abzuspielen. Teams, die dies als optional behandeln, verbringen Monate damit zu raten, was schiefgegangen ist, und können die Schleife nicht schließen. Wenn sich das Verhältnis der Ergebnisse, die das System selbst evaluieren kann, nicht von Woche zu Woche verbessert, funktioniert die Schleife nicht.
Die unglamourösen Aufgaben
Das Muster ist recht konsistent. Die Lücke zwischen der Demo und der Produktion zeigt sich als architekturelles Problem, als kulturelles Problem und als Evaluierungsproblem, ungefähr in dieser Reihenfolge, wobei jedes das nächste verstärkt.
Die Teams, die derzeit mit Agenten gewinnen, sind nicht diejenigen mit den spektakulärsten Fähigkeiten. Es sind diejenigen, die sich mit den unglamourösen Aufgaben abgefunden haben: die richtige Systemform zu wählen, zu akzeptieren, dass ein nicht-deterministisches System eine nicht-deterministische Entwicklerkultur erfordert, und die Evaluierungsschleife kontinuierlich laufen zu lassen, anstatt sie als etwas zu behandeln, das man einmal vor dem Launch erledigt.
Ingenieursdisziplin ist das, was Agenten zur Serienreife bringt. Das Modell ist der einfache Teil. Die Daten, die Guardrails, die Evaluierungsschleife und die organisatorische Bereitschaft – dort liegt die eigentliche Arbeit und dort wird der tatsächliche Wert geschaffen.
Das ist die Perspektive aus der Produktion. Sie ist weniger aufregend als die Demo, aber sie ist auch die Version, die sich auszahlt.
Jetzt beim Merantix Momentum Newsletter anmelden.
Weitere Artikel

Vom Engpass zum Durchbruch: Warum KI entscheidend für den Fortschritt in Gesundheitswesen und Pharma ist
Perspektiven aus der Praxis: Wie KI-Agenten außerhalb der Demo tatsächlich aussehen
Von Marcel Weigand, Senior AI Solutions Architect bei Merantix Momentum
Es gibt eine Version von KI-Agenten, die auf Keynote-Slides lebt, und eine Version, die in der Produktion lebt. Das sind keineswegs dieselben Systeme und so zu tun, als ob sie es wären, ist einer der kostspieligen Fehler, die ich derzeit bei Unternehmen beobachte. In einer Demo-Version nimmt ein Agent eine Anfrage in natürlicher Sprache entgegen, wägt die Nutzung mehrerer Tools ab und liefert eine saubere Antwort. In der Produktionsversion muss sich derselbe Agent mit fehlerhaften Eingaben, halb defekten vorgelagerten Pipelines, berechtigten Daten, die er nicht einsehen kann, Zeitüberschreitungen bei Tools und einem Auditor auseinandersetzen, der genau wissen möchte, warum der Agent an einem Dienstag um 03:14 Uhr genau das gesagt hat, was er gesagt hat.
Alles, was ich hier teilen möchte, stammt aus dieser zweiten Welt. Die Lücke zwischen einer Demo und der Produktion ist real, breit und tritt immer wieder auf. Doch entgegen der landläufigen Meinung ist das Modell selten der Flaschenhals: Wenn ein Kundenprojekt ins Stocken gerät, liegt das fast nie daran, dass das LLM nicht intelligent genug ist, sondern daran, dass die Systemarchitektur falsch ausgerichtet ist, die Entwicklerkultur am Nicht-Determinismus scheitert oder Evaluierungsschleifen in der Produktion fehlen. In diesem Reifestadium bringt es nichts, ein Frontier-Modell durch ein anderes zu ersetzen. Der Großteil der Arbeit bei der Bereitstellung eines Agenten ist organisatorischer und architektureller Natur, nicht algorithmischer.
1. Architektur: Sind Agenten überhaupt das richtige System?
Die erste architekturelle Frage, die es zu beantworten gilt, ist, ob Sie überhaupt einen Agenten bauen sollten. Ingenieursdisziplin beginnt damit, zu bewerten, ob ein Agenten-Setup wirklich notwendig ist, anstatt es standardmäßig vorauszusetzen. Ein Großteil der Anfragen der Kategorie „Wir brauchen einen KI-Agenten“ erweist sich als Standard-Workflow mit einem einzigen unscharfen Schritt. Das Extrahieren von Feldern aus einer Rechnung oder das Klassifizieren eines Support-Tickets erfordert keinen Agenten. Dies sind lineare Pipelines, bei denen ein LLM unstrukturierte Texte verarbeitet und traditionelle Software den Rest erledigt.
Ein Agent ist dann die richtige Architektur, wenn der Pfad selbst variabel ist. Das bedeutet, dass das System während der Laufzeit tatsächlich entscheiden muss, was als Nächstes zu tun ist, welche Tools in welcher Reihenfolge aufgerufen werden sollen und zwar basierend auf dem, was es gerade gelernt hat. Das betrifft eine weit kleinere Gruppe von Problemen, als der aktuelle Diskurs vermuten lässt. Die Fehlklassifizierung eines Workflows als Agent bringt reale Kosten mit sich: höhere Latenz, höhere Ausgaben, erschwertes Testen, schwierigeres Debugging und weniger Vorhersehbarkeit, was besonders dann zählt, wenn der Nutzer ein zahlender Kunde oder eine Regulierungsbehörde ist.
Ein nützlicher Weg, um herauszufinden, in welcher Situation Sie sich befinden, ist die Beantwortung von vier Fragen zum Prozess:
- Handelt es sich bei der Eingabe um strukturierte Daten oder um unstrukturierte, komplexe natürliche Sprache?
- Ist die Abfolge der Schritte festgelegt oder muss das System diese je nach Situation entscheiden?
- Ist fest codiert, welche externen Systeme aufgerufen werden, oder muss das System wählen?
- Und was kostet ein Fehler? Ist er günstig und korrigierbar oder teuer und unumkehrbar?
Je mehr diese Aspekte in Richtung „variabel“ und „teuer“ tendieren, desto eher rechtfertigt ein Agent seinen Preis. Geht man die Liste ehrlich durch, ordnet man ein gegebenes Problem öfter als gedacht weiter links ein, als die ursprüngliche Anforderung vermuten ließ.
Gelangt man zu dem Schluss, dass tatsächlich ein Agent benötigt wird, ist der Reflex, einen Agenten zu bauen, der alles kann, meist immer noch falsch. Kleine Agenten mit eng gestecktem Rahmen lassen sich leichter evaluieren, debuggen, sichern und ihnen fällt es leichter, Vertrauen aufzubauen. Bevor Sie irgendetwas bauen, berücksichtigen Sie ein zentrales Szenario: Was ist das Schlimmste, was dieser Agent plausiblerweise tun könnte? Da kleinere Agenten definierbarere und begrenzte Fehlermöglichkeiten haben, prägt die Identifizierung dieses Worst-Case-Szenarios direkt Ihre Tool-Grenzen. So entwickeln Sie schrittweise verlässliche Systeme, die gezielt auf Fehlerminimierung ausgelegt sind und auch in regulierten Bereichen sicher eingesetzt werden können.
2. Kultur & Nicht-Determinismus: Nicht-Determinismus bricht Ihre Entwicklerkultur
Selbst mit der richtigen Architektur tritt die nächste erschwerende Herausforderung auf: Ihr Entwicklungsteam ist selten darauf vorbereitet, wie sich nicht-deterministische Systeme verhalten. Softwareteams haben dreißig Jahre lang Gewohnheiten rund um deterministische Systeme aufgebaut: Code schreiben, Test schreiben, grüner Build, Deployment. Agenten verhalten sich nicht so. Derselbe Prompt kann unterschiedliche Ergebnisse liefern. Ein Tool-Aufruf, der zweimal erfolgreich war, kann beim dritten Mal auf eine Weise fehlschlagen, die schwer zu reproduzieren ist. Traditionelle CI- und Incident-Response setzen ein Maß an Reproduzierbarkeit voraus, das schlichtweg nicht gegeben ist.
Das erzwingt einen kulturellen Wandel, den Teams oft unterschätzen. Sie brauchen Entwickler, die in Verteilungen statt in Zusicherungen (Assertions) denken; Produktmanager, die Erfolg als „akzeptables Verhalten über eine Vielzahl von Interaktionen hinweg“ definieren; und eine Führungsebene, die akzeptiert, dass Fehler bis zu einem gewissen Grad normal sind, ohne bei jeder kleinen Abweichung direkt den Notfall auszurufen.
Dieser kulturelle Wandel speist direkt die letzte Komplexitätsebene: die Evaluierung. Sobald Sie Verteilungen statt fixer Zusicherungen ausliefern, kann die Frage, ob das System gut genug ist, nicht mehr statisch während der Entwicklung gelöst werden. Stattdessen erfordert sie eine kontinuierliche Schleife in der Produktion.
3. Evaluierung: Die Lücke, die Sie während der Entwicklung nicht schließen können
Die Evaluierung hat ein zugrunde liegendes epistemisches Problem: Sie können während der Entwicklung nicht an alle Sonderfälle denken, weil Sie noch nicht wissen, was echte Nutzer tun werden. Testfälle decken die Situationen ab, die Sie sich vorstellen können und diese neigen dazu, genau die Szenarien zu bevorzugen, die das System bereits gut beherrscht.
Synthetische Testsets helfen, aber nur bis zu einem gewissen Grad. Ein Ansatz besteht darin, in einem Workshop mit einem Fachexperten die zugrunde liegenden Geschäftsregeln und eine kleine Gruppe realer Beispiele zu erfassen und daraus ein weit größeres synthetisches Testset zu generieren. Der Agent läuft dagegen an und die Ergebnisse werden in drei Ebenen geprüft: deterministische Zusicherungen für alles mit einer klaren richtigen Antwort, ein LLM-as-a-Judge für unschärfere Fälle und nur die wirklich ungewissen Ergebnisse werden an den Fachexperten weitergeleitet. Alles andere evaluiert das System selbst.
Die zwei Schleifen und die Rolle des Fachexperten darin sehen wie folgt aus:
Die rechte Hälfte des Diagramms verhindert, dass die Offline-Evaluierung veraltet ist. Reale Nutzer werden immer Fälle finden, an die niemand im Vorhinein gedacht hat. Deshalb brauchen Sie die zweite Schleife, die kontinuierlich in der Produktion läuft: referenzfreie Prüfungen des Live-Traffics, die Fundierung, Sicherheit und Selbstkonsistenz abdecken und keine Referenzantwort benötigen, um ausgeführt zu werden; plus ein kleiner Strom von markierten und gesampelten Spuren (Traces), die überprüft und in das Referenzset zurückgeführt werden. Das nächste Release läuft gegen das verbesserte Set. Ohne diese Schleife driftet die Offline-Evaluierung stillschweigend von dem ab, was bei realen Nutzern tatsächlich passiert.
Damit all das funktioniert, ist eine ordentliche Observability erforderlich: Transparenz auf Trace-Ebene in jeden Prompt, jeden Abruf, jeden Tool-Aufruf und jeden erneuten Versuch (Retry) sowie die Möglichkeit, eine vollständige Sitzung von Anfang bis Ende erneut abzuspielen. Teams, die dies als optional behandeln, verbringen Monate damit zu raten, was schiefgegangen ist, und können die Schleife nicht schließen. Wenn sich das Verhältnis der Ergebnisse, die das System selbst evaluieren kann, nicht von Woche zu Woche verbessert, funktioniert die Schleife nicht.
Die unglamourösen Aufgaben
Das Muster ist recht konsistent. Die Lücke zwischen der Demo und der Produktion zeigt sich als architekturelles Problem, als kulturelles Problem und als Evaluierungsproblem, ungefähr in dieser Reihenfolge, wobei jedes das nächste verstärkt.
Die Teams, die derzeit mit Agenten gewinnen, sind nicht diejenigen mit den spektakulärsten Fähigkeiten. Es sind diejenigen, die sich mit den unglamourösen Aufgaben abgefunden haben: die richtige Systemform zu wählen, zu akzeptieren, dass ein nicht-deterministisches System eine nicht-deterministische Entwicklerkultur erfordert, und die Evaluierungsschleife kontinuierlich laufen zu lassen, anstatt sie als etwas zu behandeln, das man einmal vor dem Launch erledigt.
Ingenieursdisziplin ist das, was Agenten zur Serienreife bringt. Das Modell ist der einfache Teil. Die Daten, die Guardrails, die Evaluierungsschleife und die organisatorische Bereitschaft – dort liegt die eigentliche Arbeit und dort wird der tatsächliche Wert geschaffen.
Das ist die Perspektive aus der Produktion. Sie ist weniger aufregend als die Demo, aber sie ist auch die Version, die sich auszahlt.


